Benchmarks und Paper
Code-Navigation: 115 Aufgaben, vier Modelle
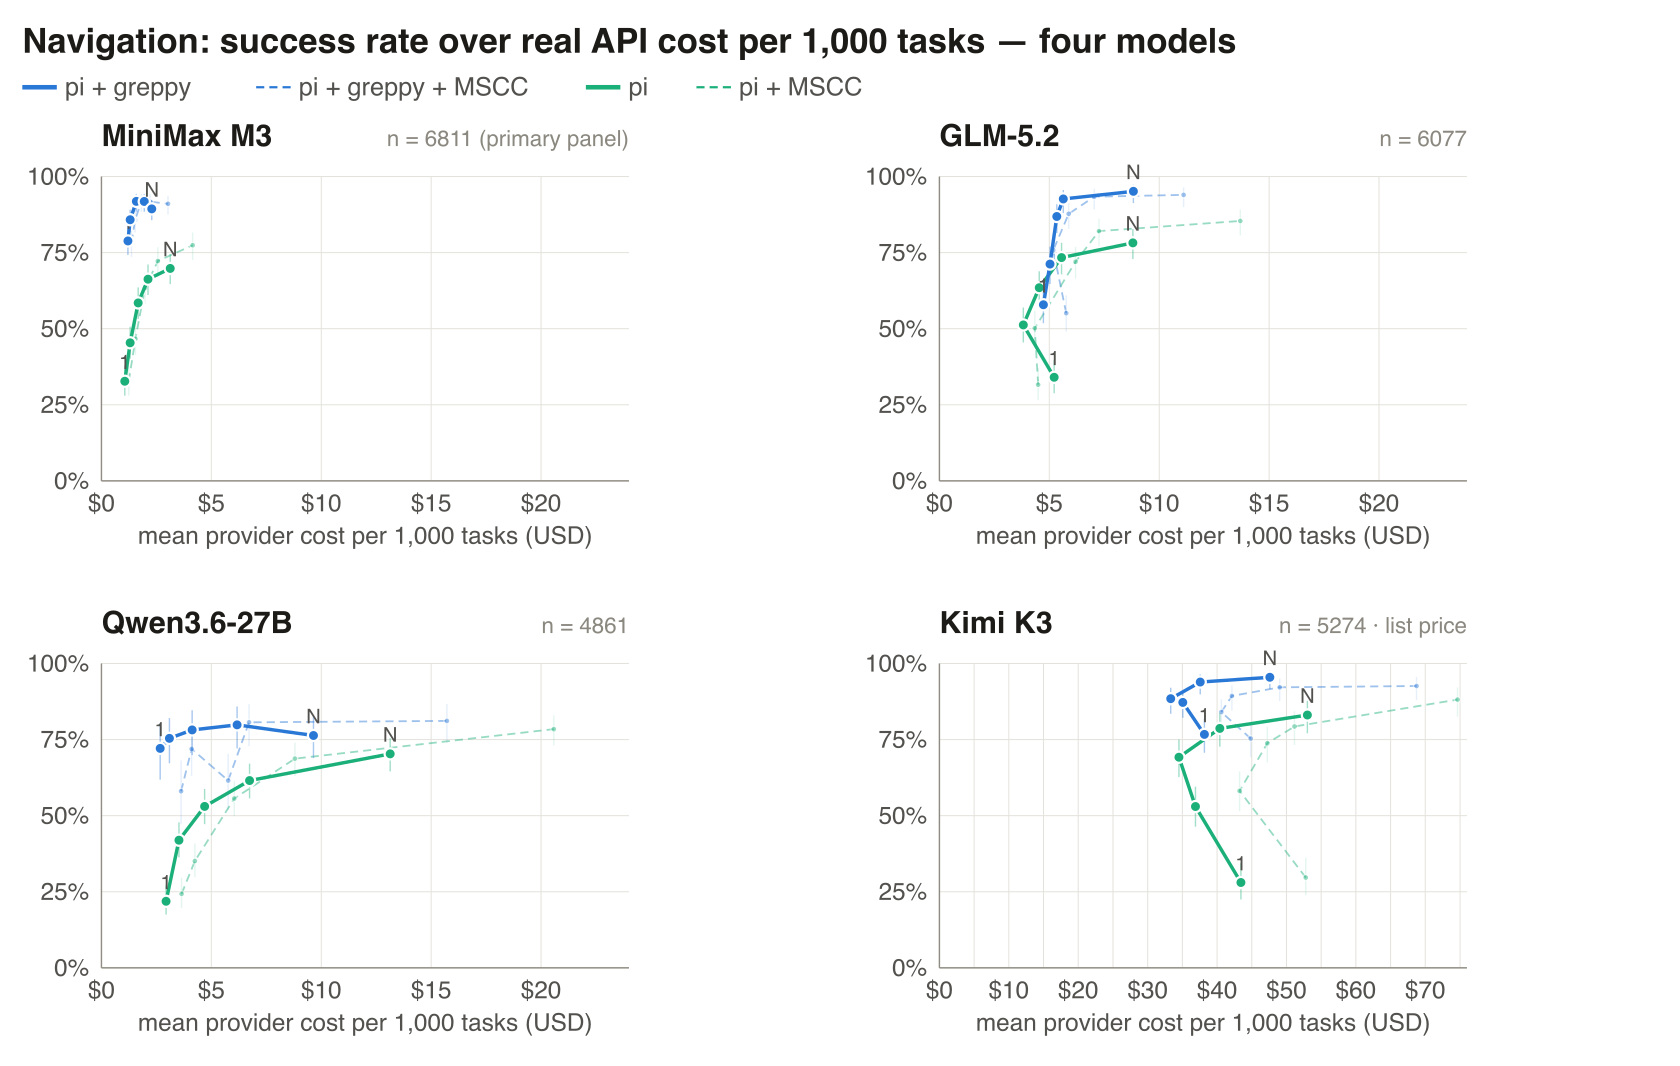
In einem Benchmark mit 115 Aufgaben und vier Coding-Modellen von drei Anbietern (MiniMax-M3, GLM-5.2, Qwen3.6-27B, Kimi-K3) beantwortete ein Agent mit greppy 6 bis 50 Prozentpunkte mehr Fragen richtig als derselbe Agent mit grep, bei jedem Budget an Tool-Aufrufen. Die beste Qualität des grep-Agents erreichte er mit 37 bis 80 % niedrigeren abgerechneten API-Kosten; andersherum zahlte der grep-Agent für seine beste Qualität das 1,6- bis 5-Fache.
Das Diagramm zeigt die Erfolgsquote gegen die mittleren abgerechneten API-Kosten pro 1.000 Aufgaben, mit dem Agenten mit greppy in Blau und demselben Agenten mit grep in Grün. Seine gestrichelten Linien sind die 2×2-Ablation: Eine ausdrückliche Methodenanweisung ändert nichts außer den Kosten, die Wirkung kommt also von der Werkzeugoberfläche.
Studiendesign
Die Studie ist ein vorab registriertes faktorielles Design. Für jedes der vier Modelle lief:
| Faktor | Stufen |
|---|---|
| Aufgaben | 115 (96 echte, 19 Kontrollen) in 6 festgelegten Repositories |
| Bedingungen | 4 |
| Budgets an Tool-Aufrufen | 5: 1, 2, 4 und 8 Aufrufe sowie natürliches Ende (Obergrenze 16 Aufrufe) |
| Wiederholungen | 3 |
Der Vergleich hält Agent und Modell immer fest und ändert das Werkzeug: grep oder greppy. Die 2×2-Ablation fügt zusätzlich eine ausdrückliche Methodenanweisung hinzu. Das Paper enthält das eingefrorene Protokoll und die Panels der vier Modelle.
Das Paper
Das Paper The Minimum Sufficient Code Context Problem — Complexity, Discovery Overhead, and Approximation in Coding Agents stammt von Michael Welsch, GPT-5.6 Sol und Fable 5.0 und erschien im Juli 2026.
Das Paper definiert den minimalen hinreichenden Code-Kontext (MSCC), den ein Agent für eine Aufgabe braucht, und beweist, dass seine exakte Konstruktion NP-vollständig ist. Es gibt eine untere Schranke dafür an, was rein lexikalische Navigation für mehrdeutige Einstiege und unaufgelöste Beziehungen bezahlen muss, und nennt die messbaren Bedingungen, unter denen die kombinierte Strategie, die greppy umsetzt, ohne Verlust an Korrektheit echt günstiger ist. Es enthält auch die vollständigen empirischen Belege über vier Modelle.
Die Benchmark-Suiten
Zwei vorab registrierte Benchmark-Suiten liegen im Repository:
bench/agent_efficiency/ enthält 115 festgelegte Navigationsaufgaben in sechs echten Repositorys plus deterministische Kontrollen. Sie misst die Korrektheit der Antwort zusammen mit den Kosten für Suche, Quelltext-Lesen und Kontext.
bench/agent_coding/ enthält 41 gepaarte Aufgaben aus Editieren und Testen, abgeleitet aus echten Commits von Flask, Hugo, Gson, Zod, Serde und Tokio; 18 davon sind ernsthafte Änderungen über mehrere Dateien (80 bis 800 Zeilen) aus echten Issues. Jede Aufgabe:
- startet beim Eltern-Commit des echten Commits;
- nimmt den Test-Diff des Commits als fehlschlagende Spezifikation, maschinell belegt: rot auf dem Eltern-Commit, grün mit der echten Änderung;
- verbirgt den Code-Diff und gibt dem Agent die Absicht aus dem echten Issue;
- lässt den Test nach dem Agent-Lauf über die Korrektheit entscheiden.
Das Setup zählt nicht zur gemessenen Agent-Zeit.
Was aufgezeichnet wird
Beide Suiten zeichnen für denselben Agent und dasselbe Modell auf: Korrektheit pro Aufgabe, Tool-Aufrufe, geöffnete Quelldateien, Input- und Output-Token, Kontext- oder Prompt-Volumen und Wandzeit. Aufgabenbänke, Prompts, Binarys, Laufzeitversionen, Setup-Befehle und Repository-Commits gehen als Hashes in die Manifeste ein. Die Reihenfolge der Arme ist pro Aufgabe deterministisch ausgeglichen, und das Reihenfolge-Schema ist im Manifest versioniert.
Jeder Diagnoselauf veröffentlicht die exakten Repository-Commits, den Hash der Aufgabenbank, den Prompt-Hash, die Modell-ID, den Hash des greppy-Binarys, die Zeilen pro Aufgabe, die Bewertung, das Aggregat und die Forensik. Rohe Agent-Traces bleiben privat und sind keine Release-Artefakte.
Diagnose, kein Gate
Agent-Benchmarks laufen fortlaufend auf Kandidaten-Commits als Diagnose. Sie halten die Veröffentlichung des getesteten Releases nie auf. Ihre Ziele sind:
- mindestens so viele gepaarte Korrektheitsgewinne wie Verluste, ohne gepaarten Regressionsalarm bei
p < 0.05; - mindestens 20 % weniger Tool-Aufrufe und geöffnete Quelldateien bei strukturellen Aufgaben;
- mindestens 20 % weniger variable Input-Token bei strukturellen Aufgaben.
Befunde werden vor jeder Produktänderung eingeordnet, als Produkt-, Harness-, Prompt-, Bedienungs- oder erwartetes Testverhalten, und fließen als Korrekturen in ein späteres Release. Der Indexaufbau ist einmalige Arbeit pro Repository und wird getrennt mit seinem Break-even berichtet.
Die Demo
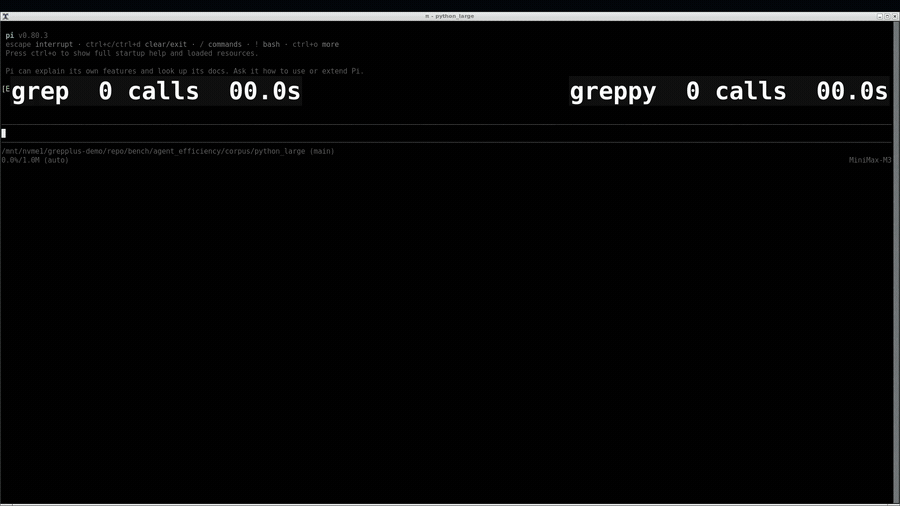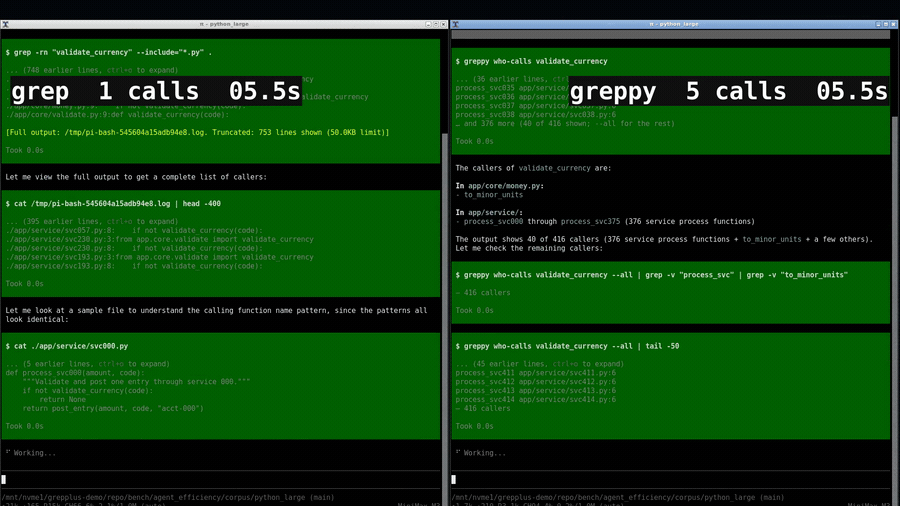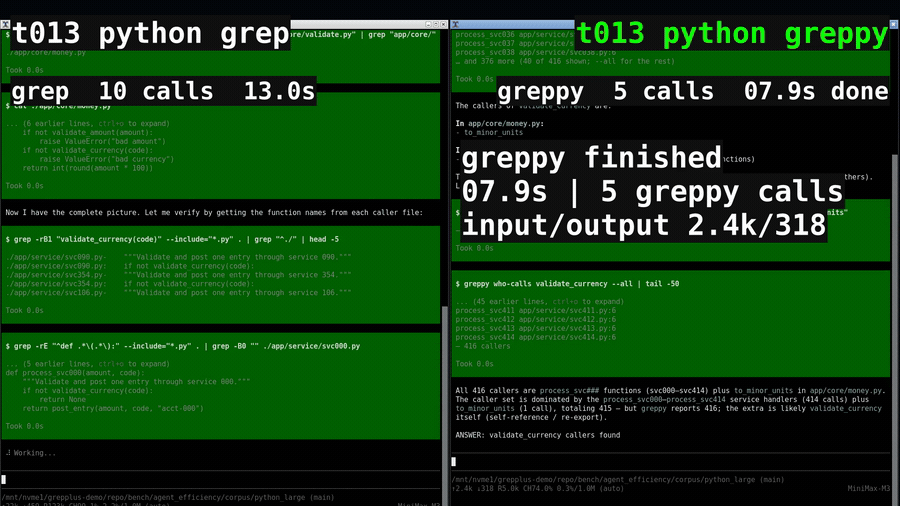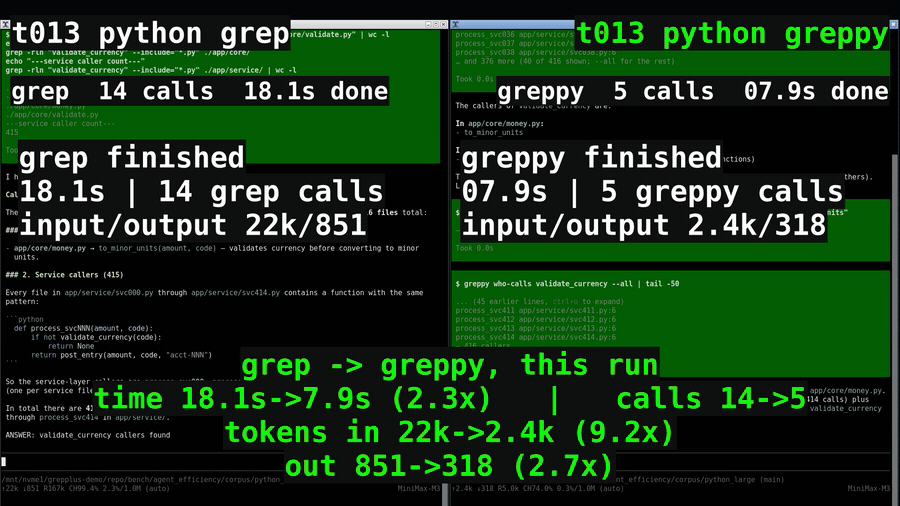
In der Demo beantwortet derselbe Coding-Agent (MiniMax-M3, gesteuert von Pi) eine who-calls-Frage an einem echten Repository: links mit grep, rechts mit greppy.
Auf deinem Repository ausprobieren
greppy trial führt eine isolierte Beobachtung ohne und mit greppy auf deinem eigenen Repository aus, mit Pi als Agent-Runner, und druckt einen JSON-Datensatz greppy.project-trial.v1:
greppy trial --help